
半導体プロセッサチップが支える電子産業とAI革命

私はアドミンとしてお仕事をさせていただきます。今私はベトナムに住んでいます。もしご都合がよければぜひベトナムへ一回に行ってください。私はアドミンとしてお仕事をさせていただきます。今私はベトナムに住んでいます。もしご都合がよければぜひベトナムへ一回に行ってください。私はアドミンとしてお仕事をさせていただきます。今私はベトナムに住んでいます。
1. はじめに:半導体チップは「現代の基盤インフラ」
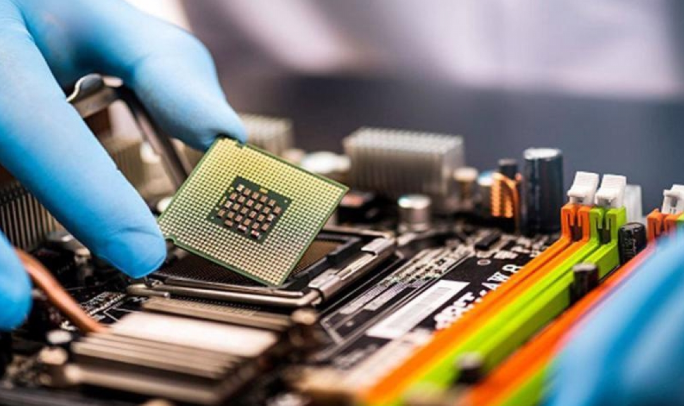
スマートフォン、PC、家電、自動車、産業機器、クラウドサービスに至るまで、現代の電子産業は半導体なしには成立しない。なかでもプロセッサ(処理チップ)は、機器やサービスの「頭脳」として演算を担い、製品価値の中心を形成している。近年は生成AIの急速な普及により、従来の汎用計算だけでなく、大規模な行列演算や推論処理を効率よく実行できる計算基盤が不可欠となった。こうした流れの中で、CPUだけでなくGPU、NPU(Neural Processing Unit)、TPUに代表されるAIアクセラレータ、そしてそれらを統合するSoC(System on Chip)が競争の主戦場になっている。
半導体プロセッサの重要性は「性能向上」だけではない。電力効率、熱設計、供給網、設計自動化(EDA)、パッケージング、メモリ技術、ソフトウェア最適化まで、複数要素が絡み合う総合力が産業競争力を左右する。AI時代には、モデル規模とデータ量の拡大がチップ需要を押し上げる一方、エネルギー制約や製造難度の上昇がボトルネックにもなる。本稿では、半導体プロセッサの全体像を整理し、電子産業とAIの両面から、今後の展望と課題を読み解く。
2. プロセッサチップの基本:CPU・GPU・NPUの役割分担
2.1 CPU:汎用性と制御の中心
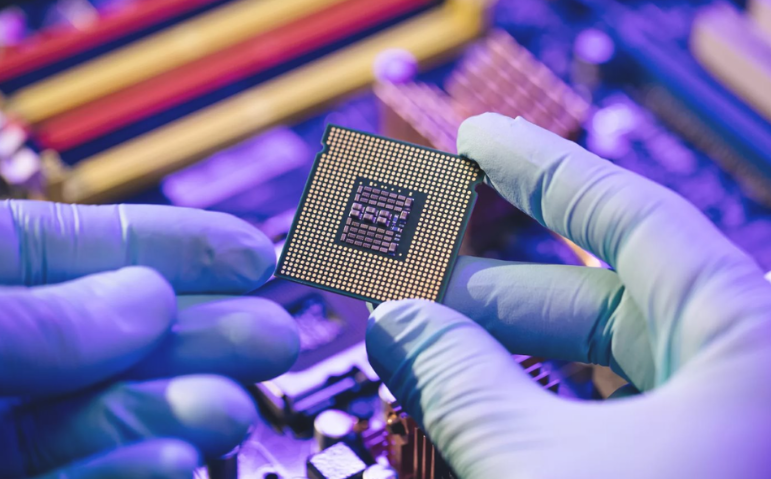
CPU(Central Processing Unit)は、OSやアプリケーションの制御、分岐の多い処理、システム全体の調停に強みを持つ。命令セット(例:x86、Arm)を基盤とし、単一スレッド性能や低遅延が重要視される。AIワークロードでもCPUは不可欠だが、巨大な行列計算を大量に回す「学習」では、CPU単体では効率が低いことが多い。そのためCPUは、前処理、データ供給、タスク管理、I/O制御など、計算資源を束ねる役割へ比重が移っている。
2.2 GPU:並列計算の王者
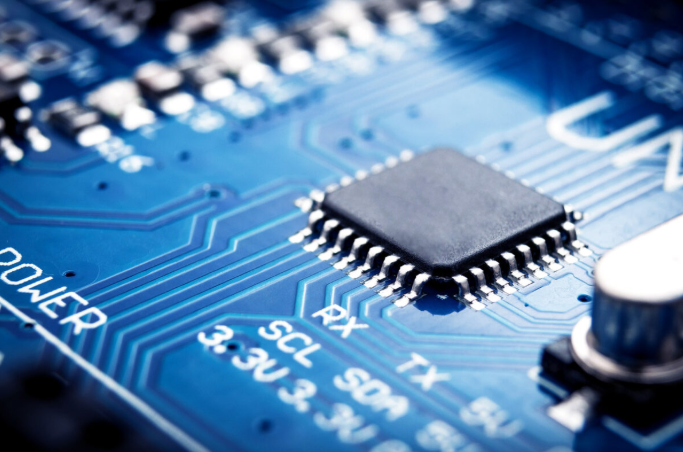
GPU(Graphics Processing Unit)は本来、画像描画のために多数の演算ユニットを並列に動かす設計が進化した。AIの学習・推論で中心となる行列演算(GEMM)や畳み込みは、高い並列性と相性が良く、GPUがAI計算の主役になった。特にデータセンターでは、GPUを複数枚接続し高速ネットワークで束ね、分散学習を行う構成が一般的である。GPUは汎用並列計算にも適用できるため、エコシステム(CUDA等)と合わせて強固な地位を築いてきた。
2.3 NPU/AIアクセラレータ:目的特化で電力効率を追求
NPUはニューラルネットワーク処理に最適化された回路を持ち、推論を低消費電力で高速に実行することを主眼とする。スマートフォンやIoT機器、自動車の運転支援など、電力制約が厳しいエッジ環境で特に重要だ。目的特化により電力効率を高められる反面、対応する演算形式やソフトウェア基盤が限定されがちで、開発・運用にはツールチェーン整備が不可欠となる。
2.4 SoC:統合による最適化
近年の主流は、CPU・GPU・NPU・ISP(画像信号処理)・DSP・メモリコントローラ・セキュリティ機能などを1チップに統合したSoCである。統合によりデータ移動のオーバーヘッドが減り、消費電力や遅延を抑えられる。スマホSoCは典型例であり、AI機能はカメラの画像処理、音声認識、翻訳、生成AIの一部推論など、ユーザー体験を左右する差別化要素になっている。
3. AI時代に「計算」が爆発する理由:学習と推論の違い
AIワークロードは大きく「学習(training)」と「推論(inference)」に分けられる。
- 学習:膨大なデータを使いモデルの重みを更新する工程。計算量が非常に大きく、メモリ容量・帯域、GPU間通信、消費電力、冷却が課題になる。データセンター中心。
- 推論:学習済みモデルを用いて、入力から出力を生成する工程。クラウドでもエッジでも実行される。リアルタイム性、コスト、電力効率、レイテンシが重要になる。
生成AIの普及で推論需要が爆発的に増えると、単に高性能なチップを作るだけでなく、**「1回の応答に必要な計算量」「メモリアクセス」「量子化や圧縮」「バッチ処理の設計」**といった最適化が競争力を左右するようになった。さらに、学習でも推論でも共通して問題になるのが、演算よりもデータ移動がボトルネックになりやすい点である。つまり、チップの進化は計算ユニットだけでなく、メモリ階層や帯域、インターコネクト、パッケージ技術と不可分になっている。
4. 性能を決める指標:FLOPSだけでは測れない
従来、プロセッサ性能はクロック周波数やコア数、理論演算性能(FLOPS)で語られがちだった。しかしAI時代には、次の指標がより重要になる。
- 電力効率(性能/W):データセンターでは電力コストと発熱が制約。エッジではバッテリー寿命と発熱が制約。
- メモリ帯域と容量:巨大モデルでは重みを載せるメモリが足りなければ性能が出ない。帯域不足はスループットを低下させる。
- 低レイテンシ:対話型AI、車載、ロボットなどは応答遅延がユーザー体験や安全性に直結する。
- 精度形式への対応(FP32/FP16/BF16/INT8等):AIは低精度化で高速化・省電力化できるが、モデル品質とのトレードオフがある。
- ソフトウェアエコシステム:コンパイラ、ライブラリ、分散学習フレームワーク、運用ツールが揃わないと性能を引き出せない。
結局のところ、AI向けチップの競争は「ハードだけ」では決まらず、ソフトウェアと運用設計を含めたプラットフォーム戦争になっている。
5. 製造技術の要点:微細化・歩留まり・コストの三角関係
半導体製造は、設計(ファブレス)と製造(ファウンドリ)に分業されることが多い。最先端プロセスでは、露光装置、材料、工程管理が極めて高度化し、投資額も莫大だ。
- 微細化(先端ノード):トランジスタ密度向上により性能・電力効率が改善しやすいが、工程が複雑化しコストが上がる。
- 歩留まり(Yield):欠陥率が少し上がるだけで製品単価が急上昇する。大面積チップほど歩留まりに不利。
- 開発コスト:マスク費用、検証、EDAライセンス、IP利用料などが膨らみ、先端ノードの参入障壁を高める。
AI向け高性能チップはダイサイズが大きくなりがちで、歩留まりとコストの問題が顕在化する。その解として、後述するチップレットや先端パッケージが注目されている。
6. パッケージと実装の進化:チップレットと3D積層
6.1 チップレット:分割して最適に作る
チップレットは、巨大な1枚のダイを作る代わりに、機能を複数ダイに分割し、高速インターコネクトで接続する設計思想である。利点は、歩留まり改善、異なるプロセスの併用(例:演算は先端、I/Oは成熟)、製品バリエーションの作りやすさなど。一方で、接続規格、遅延、熱、設計複雑性が課題となる。
6.2 2.5D/3Dパッケージ:メモリとの距離を縮める
AIではメモリ帯域が重要であり、HBM(High Bandwidth Memory)を近接配置する2.5D実装が普及している。さらに、ロジックとメモリを積層する3D化も進む。配線距離が短くなることで帯域・電力効率に利点がある一方、熱密度が上がり冷却が難しくなる。
7. エッジAIとデータセンターAI:求められるチップは異なる
7.1 エッジAI:省電力・リアルタイム・プライバシー
エッジでは、スマホ、監視カメラ、工場設備、車載ECUなどが対象になる。求められるのは、低消費電力、即時応答、通信が不安定でも動く堅牢性、データを端末内で処理するプライバシー保護などだ。NPUをSoC内に統合し、量子化モデルや蒸留モデルを用いて推論を軽量化する設計が一般的になる。
7.2 データセンターAI:最大スループットと運用最適化
クラウド側は、学習・大規模推論を担う。ここでは電力・冷却・ラック密度・ネットワークが支配的で、単体チップの性能だけでなく、クラスタ全体の効率が重要になる。GPU/アクセラレータ間通信(高速インターコネクト)や、モデル並列・データ並列の戦略、ジョブスケジューリングが運用コストに直結する。
8. サプライチェーンと地政学:電子産業の「現実」
半導体は材料、製造装置、設計IP、EDA、ファウンドリ、OSAT(後工程)、基板、検査装置など、国際分業の集合体である。特定の工程・地域に依存が偏ると、自然災害、政治的リスク、輸出規制、物流混乱によって供給不安が起きる。近年、各国が半導体投資や国内生産能力の確保を急ぐ背景には、経済安全保障の観点がある。
企業戦略としては、複数ソース化、成熟ノードの活用、在庫・調達の最適化、設計の共通化などが重要になる。同時に、AI需要の変動は大きく、過剰投資と供給不足の波が起きやすい。チップ産業は、技術だけでなくマクロ環境にも強く影響される。
9. 今後の技術潮流:次の主戦場
- 省電力化の徹底:電力が最大制約になり、性能/Wが最重要指標になる。電源設計、DVFS、近似計算、量子化が鍵。
- メモリ中心設計:計算よりデータ移動が高コストであるため、HBM拡大、メモリ階層最適化、近メモリ演算の研究が進む。
- チップレット標準化:接続インターフェースや設計手法が成熟すれば、モジュール交換型の設計が進み、開発速度が上がる。
- ソフトウェアとコンパイラ最適化:同じハードでもソフト最適化で体感性能が変わる。モデルのスパース性活用、カーネル融合などが重要。
- 用途別AIチップの多様化:汎用GPU一強から、推論特化、動画解析特化、車載安全特化など、用途最適の設計が広がる。
10. 課題:エネルギー、熱、開発コスト、人材
AIの成長は半導体の需要を押し上げるが、同時に課題も深刻化する。第一に、電力消費と冷却。データセンターの電力は社会インフラと競合し、再生可能エネルギー活用や効率化が必須になる。第二に、先端ノードのコストと開発期間。設計の複雑化により、検証やソフト対応も含めた総コストが膨らむ。第三に、人材不足。回路設計、物理設計、パッケージ、EDA、組込みAI最適化など専門領域が広く、育成には時間がかかる。
これらを踏まえると、今後は「最先端ノードだけが正義」ではなく、成熟プロセスと先端パッケージの組み合わせ、ソフト最適化、運用設計によって、トータルの価値を最大化する方向へ進む可能性が高い。
11. まとめ:半導体プロセッサはAI時代の競争力そのもの
半導体プロセッサチップは、電子産業の基盤であると同時に、AIの性能と普及速度を左右する中核技術である。CPU・GPU・NPUの役割分担、メモリ帯域と電力効率、先端プロセスとパッケージング、そしてソフトウェアエコシステムの統合が、製品・サービスの競争力を決める。生成AIの拡大により計算需要はさらに増えるが、エネルギーや供給網、開発コストという現実的制約も強まるだろう。だからこそ、ハードとソフト、設計と製造、エッジとクラウドを俯瞰した最適化が、次世代の電子産業とAIの発展を支える鍵となる。
New Articles/新着記事
ロピア公式をフォローして最新情報をチェック!


